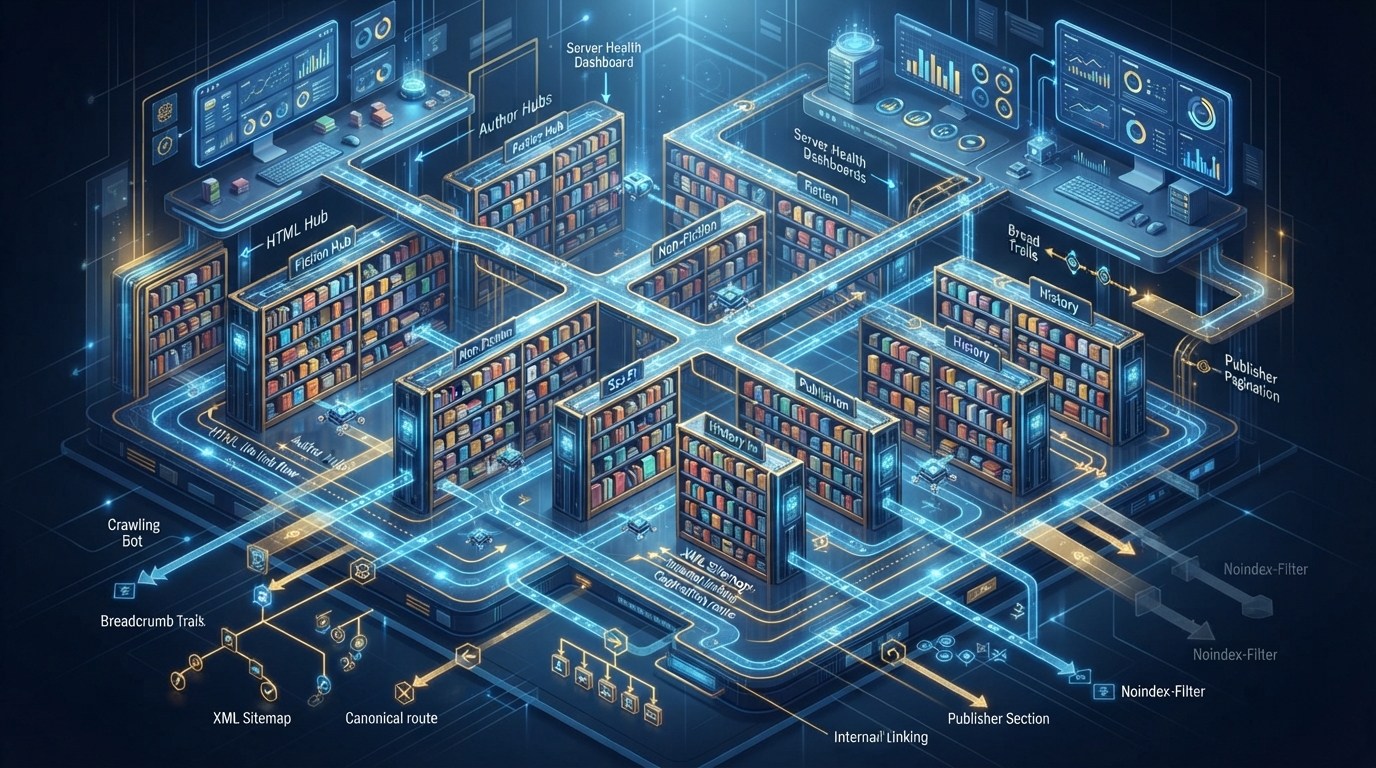
نکات کلیدی درباره سئو سایت کتاب و مجله
- ایندکس شدن همه URLها هدف نیست و صفحات دارای تقاضا و محتوای یکتا اولویت دارند.
- صفحهبندی فهرست کتاب باید لینکهای HTML قابلخزش و مسیر ناوبری روشن داشته باشد.
- صفحات فیلتر تکراری، جستوجوی داخلی و ترکیبهای کمارزش معمولاً نباید وارد ایندکس شوند.
- نقشه سایت XML و گزارشهای Search Console خطاهای خزش و URLهای فراموششده را آشکار میکنند.
- لینکسازی داخلی از دسته، نویسنده و کتابهای مشابه، کشف صفحات ارزشمند را سریعتر میکند.
وقتی یک فروشگاه کتاب چند هزار عنوان، نویسنده، ناشر، موضوع و صفحه فهرست دارد، مسئله فقط تولید صفحه نیست؛ مسئله این است که گوگل کدام URL را پیدا کند، بخزد و ارزش نمایش در نتایج بداند. سئو سایت کتاب و مجله در چنین پروژهای به انتخاب آگاهانه میان صفحات مفید و انبوه URLهای تکراری وابسته است، چون ایندکس بیهدف میتواند گزارشهای Search Console را شلوغ و بودجه خزش را مصرف کند. در این راهنما، معیارهای عملی برای معماری محتوا، صفحهبندی، کنترل فیلترها و پایش خطاها را با مثالهای قابل اجرا مرور میکنیم.
برای سایت کتاب، چه صفحاتی واقعاً باید ایندکس شوند؟
ایندکس یعنی ثبت و نگهداری یک صفحه در پایگاه داده موتور جستوجو تا بتواند در پاسخ به جستوجوها نمایش داده شود؛ ایندکس شدن با رتبه گرفتن یکسان نیست. در یک کتابفروشی بزرگ، صفحه اختصاصی هر کتاب چاپی یا دیجیتال، صفحه نویسنده شناختهشده، صفحه ناشر و دسته موضوعی دارای تقاضا معمولاً ارزش ایندکس دارند، زیرا پاسخ مشخصی به جستوجوی کاربر میدهند. اما URLهایی که فقط ترتیب نمایش را عوض میکنند، مانند «ارزانترین»، «پرفروشترین» یا «صفحه ۲» همراه با چند فیلتر، اغلب محتوای تازهای تولید نمیکنند.
معیار اصلی این است که هر URL ایندکسپذیر باید عنوان، توضیح، فهرست کالا و هدف جستوجوی متمایز داشته باشد. برای نمونه، صفحه «کتابهای صادق هدایت» اگر معرفی کوتاه نویسنده، آثار مرتبط و لینک به کتابها دارد، یک مقصد مستقل است؛ ولی ترکیب «صادق هدایت + موجودی انبار + قیمت نزولی» معمولاً نسخهای از همان فهرست است. در راهنمای رسمی سئو گوگل نیز خزش، ایندکس و فهم محتوای صفحه سه گام جدا از هم معرفی شدهاند؛ بنابراین صرف قابلدسترسی بودن URL، دلیل کافی برای نگهداشتن آن در نتایج نیست.
شاخصهای کلیدی بررسی سئو سایت
برای تصمیمگیری، ابتدا URLها را به چهار گروه صفحه محصول، آرشیو موضوعی، صفحه نهادی مانند نویسنده و ناشر، و صفحات سیستمی تقسیم کنید. سپس برای هر گروه تعداد کلیک، نمایش، وضعیت ایندکس، تعداد لینک داخلی، تکراری بودن عنوان و نرخ پاسخ سرور را در یک فایل ثبت کنید. اگر صفحهای طی چند ماه نمایش جستوجو ندارد و فقط همان فهرست یک دسته را با پارامتر متفاوت نشان میدهد، نگهداشتن آن در نقشه سایت XML منطقی نیست.
| نوع URL | تصمیم پیشنهادی | دلیل اجرایی |
|---|---|---|
| صفحه اختصاصی کتاب | ایندکس | نام کتاب، ISBN، نویسنده و توضیح یکتا دارد. |
| دسته موضوعی اصلی | ایندکس | برای جستوجوهایی مانند «رمان تاریخی» مقصد مستقلی است. |
| فیلتر چندگانه و مرتبسازی | معمولاً noindex | ترکیبهای زیاد، فهرستهای نزدیک به هم میسازند. |
| نتیجه جستوجوی داخلی | معمولاً noindex | عبارتهای تصادفی کاربران صفحه کمکیفیت ایجاد میکنند. |
صفحهبندی درست فهرست کتابها چگونه پیادهسازی میشود؟
صفحهبندی یا Pagination یعنی تقسیم یک فهرست بلند به URLهای متوالی، مانند صفحه اول تا صفحه پنجاه دسته ادبیات. هر صفحه باید با لینک HTML معمولی به صفحه قبل و بعد وصل باشد، زیرا دکمهای که فقط با اسکریپت پیچیده کار میکند ممکن است برای خزنده مسیر قابل اتکایی نسازد. صفحه اول دسته را به خود صفحه اول کنونیکال کنید و برای صفحههای بعدی، canonical خودارجاعی بگذارید؛ یعنی صفحه ۳ به URL خودش اشاره کند، نه به صفحه ۱.
نباید همه صفحههای بعدی را با canonical به صفحه اول فرستاد، چون کتابهایی که فقط در صفحه ۱۲ دیده میشوند ممکن است برای گوگل سیگنال کشف ضعیفتری بگیرند. راه بهتر این است که عنوان هر صفحه تفاوت طبیعی داشته باشد، مانند «کتابهای فلسفه؛ صفحه ۳»، و متن کوتاهی درباره دامنه دسته در صفحه اول قرار گیرد. اگر برای ساختار کلی کار نیاز به ترتیب بررسی دارید، استفاده از چکلیست بهینهسازی سایت در میانه برنامه اجرایی کمک میکند تا کنترلهای تکراری مانند canonical، نقشه سایت و پاسخ سرور از قلم نیفتند.
فیلترها را از صفحهبندی جدا کنید
فیلتر «ناشر»، «رده سنی» یا «زبان» زمانی میتواند ایندکس شود که تقاضای جستوجوی مستقل و مجموعه کالای کافی داشته باشد. مثلاً «کتاب کودک انتشارات پرتقال» ممکن است یک صفحه فرود مفید باشد، اما ترکیب «کتاب کودک پرتقال، قیمت ۱۰۰ تا ۱۲۰ هزار تومان، موجود در انبار، مرتبسازی نزولی» معمولاً ارزش مستقل ندارد. برای URLهای کمارزش، متاتگ robots با مقدار noindex,follow مناسبتر از بستن کامل در robots.txt است، چون گوگل باید بتواند ابتدا دستور noindex را ببیند.
بودجه خزش و بررسی سئو تکنیکال و خطاهای کراول
بودجه خزش، مقدار ثابتی نیست که برای همه سایتها یکسان باشد؛ این مفهوم به میزان توجه Googlebot، توان پاسخگویی سرور و تعداد URLهای قابل کشف مربوط است. سایت کتابی که دهها هزار URL پارامتری تولید میکند، ممکن است درخواستهای ربات را روی نسخههای تکراری پخش کند و صفحات کتاب تازه را دیرتر به چرخه خزش برساند. ثبت گزارشهای Crawl Stats و Page Indexing در Google Search Console نشان میدهد کدام الگوهای URL بیشتر خطای 404، Soft 404، ریدایرکت زنجیرهای یا پاسخ 5xx تولید کردهاند.
خطای DNS، کندی پایدار سرور و پاسخ 503 هنگام خزش، فقط مشکل فنی نیستند؛ این رخدادها باعث میشوند ربات نتواند صفحات محصول را بهموقع دریافت کند. در بررسی سایتمپ و خطاهای DNS در سئو، فایل sitemap.xml باید فقط URLهای canonical و قابل ایندکس را شامل شود، نه تمام آدرسهایی که سیستم میتواند بسازد. نقشه سایت را به چند فایل کوچکتر بر اساس نوع محتوا، مانند کتاب، نویسنده و دسته تقسیم کنید تا هنگام خطا، منبع URL مشکلدار سریعتر پیدا شود.
طبق اصول اساسی گوگل برای وبسایتها، رعایت الزامات فنی تضمین نمیکند هر صفحه حتماً خزش یا ایندکس شود، اما مانعهای دسترسی و الگوهای اسپم میتوانند حضور در نتایج را مختل کنند. بنابراین تغییرات noindex، canonical و robots.txt را همزمان و بدون آزمایش روی کل سایت منتشر نکنید، چون یک الگوی اشتباه میتواند هزاران صفحه کتاب را از نتایج حذف کند. ابتدا روی یک دسته کوچک، بازرسی URL و گزارش ایندکس را بررسی کنید و سپس تغییر را به کل الگو گسترش دهید.
تأثیر ساختار لینکها بر سئو سایت کتاب چیست؟
لینک داخلی فقط راهنمای کاربر نیست؛ برای ربات نیز نشانهای از ارتباط و اولویت صفحات است. صفحه هر کتاب باید دستکم از صفحه دسته، صفحه نویسنده یا بخش کتابهای مشابه یک مسیر لینک HTML دریافت کند، وگرنه ممکن است به صفحه یتیم تبدیل شود؛ صفحه یتیم URLی است که در سایت به آن لینک داخلی داده نشده است. بردکرامب، مانند «خانه ← ادبیات ← رمان ایرانی ← نام کتاب»، هم مسیر بازگشت کاربر را روشن میکند و هم ارتباط سلسلهمراتبی را نشان میدهد.
در فروشگاهی که کتاب، مجله و محصولات فرهنگی را کنار هم عرضه میکند، معماری بخشها نباید همه صفحات را در یک فهرست نامرتب دفن کند. مطالعه استراتژی سئو فروشگاه آنلاین میتواند برای جداکردن صفحههای دسته، محصول و لندینگهای تجاری ایدههای عملی بدهد، بهویژه وقتی هدف، رشد همزمان ترافیک اطلاعاتی و فروش است. متن لینکها نیز باید معنیدار باشد؛ عبارت «دیگر آثار این نویسنده» برای کاربر و خزنده اطلاعات بیشتری از «بیشتر» منتقل میکند.
چرخه کنترل ماهانه
یک کنترل ماهانه کوتاه، از اصلاحهای بزرگ و پرهزینه جلوگیری میکند، زیرا رشد کاتالوگ معمولاً آرام و پیوسته است. ابتدا URLهای تازه منتشرشده، سپس صفحات خارجشده از ایندکس، و بعد گزارش خطاهای سرور را مرور کنید تا اثر تغییرات قالب یا افزونه مشخص شود. برای فروشگاههایی که صفحه محصول زیادی دارند، محتوای سئو محصولات فروشگاهی میتواند در طراحی عنوان، داده محصول و لینکهای مرتبط مفید باشد، اما الگوی کتاب باید همچنان بر ISBN، پدیدآورنده و مشخصات نشر تکیه کند.
- گزارش Page Indexing را برای افزایش ناگهانی URLهای Excluded بررسی کنید.
- نمونهای از صفحههای کتاب تازه را با URL Inspection آزمایش کنید.
- خطاهای 5xx، DNS و زمان پاسخ سرور را با تیم فنی مقایسه کنید.
- نقشه سایت را پس از ورود یا حذف گروه بزرگی از کتابها بهروزرسانی کنید.
- صفحات یتیم را از طریق خزش داخلی ابزارهایی مانند Screaming Frog پیدا کنید.
پرسشهای رایج درباره سئو سایت کتاب و مجله
آیا همه صفحههای فیلتر کتاب باید noindex شوند؟
خیر، فقط فیلترهایی را noindex کنید که صفحهای تکراری، کممحتوا یا بدون تقاضای جستوجوی مستقل میسازند. یک فیلتر محبوب مانند «کتابهای زبان آلمانی» میتواند صفحه فرود ارزشمند باشد، اگر عنوان، توضیح و مجموعه کافی از کتابها داشته باشد. تصمیم را با دادههای جستوجو و تعداد واقعی محصولات بگیرید، نه صرفاً بر اساس تعداد پارامترهای URL.
آیا برای صفحههای ۲ و ۳ دسته کتاب باید محتوای جداگانه بنویسیم؟
نیازی به نوشتن مقاله مستقل برای هر صفحه نیست، چون هدف آنها ادامه همان فهرست است. تفاوت طبیعی در عنوان، لینکهای قابلخزش و canonical خودارجاعی معمولاً کافی است، در حالی که متنهای تکراری و طولانی فقط صفحه را سنگین میکنند. محتوای معرفی اصلی را در صفحه اول دسته قرار دهید تا موضوع کلی آرشیو روشن بماند.
چرا بعضی کتابهای جدید با وجود قرارگرفتن در نقشه سایت ایندکس نمیشوند؟
نقشه سایت فقط یک نشانه برای کشف URL است و تضمین ایندکس محسوب نمیشود. اگر صفحه جدید از دسته یا نویسنده لینک ندارد، مشخصات کتاب ناقص است یا سرور هنگام خزش ناپایدار پاسخ میدهد، گوگل ممکن است آن را دیرتر بررسی کند. وجود عنوان یکتا، تصویر با متن جایگزین مناسب و لینک داخلی از یک صفحه قابلخزش، احتمال ارزیابی سریعتر را بیشتر میکند.
آیا robots.txt راه مناسبی برای حذف صفحههای کمارزش از نتایج است؟
برای حذف قطعی از نتایج، robots.txt بهتنهایی راه مناسبی نیست، زیرا ممکن است گوگل URL را بدون مشاهده محتوای صفحه بشناسد. متاتگ noindex روی صفحهای که برای خزنده قابل دسترسی است، پیام روشنتری میدهد. robots.txt بیشتر برای کاهش دسترسی ربات به مسیرهای فنی، فایلهای غیرضروری یا الگوهایی کاربرد دارد که واقعاً نباید خزش شوند.
چه زمانی حذف یک کتاب ناموجود از سایت بهتر از نگهداشتن آن است؟
اگر کتاب برای همیشه از چرخه فروش خارج شده و جایگزین یا ارزش اطلاعاتی ندارد، ریدایرکت 301 به نزدیکترین دسته یا صفحه مرتبط میتواند مناسب باشد. اگر همان اثر دوباره چاپ میشود یا صفحه برای جستوجوی ISBN و اطلاعات کتاب مفید است، آن را نگه دارید و وضعیت ناموجودی را شفاف نمایش دهید. حذف صفحهای که لینک و بازدید دارد، بدون تعیین مقصد مرتبط، معمولاً به خطای 404 و از دست رفتن مسیر کاربران منجر میشود.